Datenbank-Update Oktober 2026
Es ist so weit: unser neue Daten-Release. Ich möchte ein paar unserer Learnings und den Weg dorthin aus technischer Sicht teilen.
Experten und Einsteiger
Meine Leidenschaft für Daten reicht einige Jahre zurück, in meine Zeit im Archiv des Schweizer Radio und Fernsehenes (SRF), in dem ich meinen Zivildienst geleistet habe. Ich musste Tausende alter Volksmusikaufnahmen aus den Sechzigerjahren digitalisieren und kategorisieren. Das Tool, mit dem wir arbeiteten, war neu entwickelt worden und erfasste alle Musiktitel, im Grunde ein Spotify für den öffentlichen Rundfunk. Das Tool war ein Chaos, und ich habe noch mehr Chaos hinzugefügt.
Was hat das nun mit Niatsu zu tun, fragt du dich? Auch Niatsu ist ein Tool, in dem Menschen einen Teil ihres Arbeitsalltags verbringen, und es soll für sie funktionieren. In den letzten Jahren habe ich gemerkt, dass wir zwei Arten von Nutzern haben:
- Der Experte
- Der Einsteiger
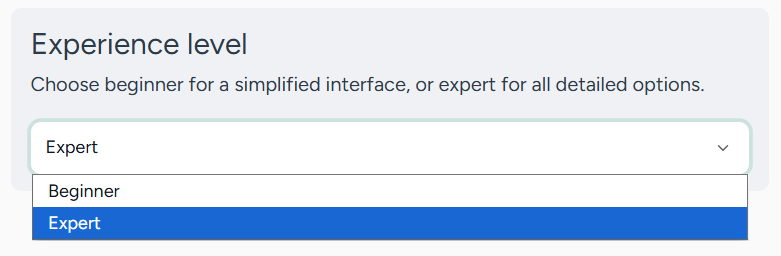
Der Experte will alle Details, möchte verstehen, woher die Emissionen stammen, und ist begeistert von der Bilanzierungsseite von Product Carbon Footprints (PCF). Wir machen diese Nutzer glücklich, wenn wir ihnen alle Informationen liefern und sie Entscheidungen selbst anpassen können. Der Einsteiger dagegen will einfach eine Zahl. Er will die Aufgabe erledigen und interessiert sich weniger dafür, wie ein PCF zustande gekommen ist, als dafür, was er damit tun soll. Keiner von beiden ist wichtiger als der andere, und beiden liegt ihre Arbeit am Herzen. Sie haben lediglich eine andere Perspektive darauf, was zählt.
Bei SRF hatte ich das Gefühl, das Tool sei für die Entwickler gebaut worden und weder für Experten noch für Einsteiger. Genau deshalb freue ich mich über unseren neusten Daten-Release. Wir fügen Niatsu Tausende eigene Datenpunkte hinzu, die mit einem neuen Grad an Granularität und Regionalisierung modelliert sind. Für den Experten ist das spannend, denn es sind bessere Daten, mit allen Informationen verfügbar im Hintergrund des Systems. Wir werden nach und nach immer mehr dieser Hintergrundinformationen für unsere Nutzer zugänglich machen.
Du willst wissen, welcher Dünger für euren Emissionsfaktor eingesetzt wurde? Kein Problem. Du willst die Erträge eines bestimmten Jahres in einer Region verstehen? Du bekommst Antworten.
Aber nicht nur der Experte profitiert, sondern auch der Einsteiger. Denn diese Daten ersetzen viele alte Daten, die Nutzer müssen nichts anpassen und erhalten trotzdem deutlich bessere Daten. Zusätzlich werden in unseren Reports immer mehr dieser Informationen verfügbar sein, was die Glaubwürdigkeit für alle stärkt, die unsere PCFs verwenden.
Was kommt neu dazu?
Das ist unser grösstes Daten-Release überhaupt, gemessen an den Qualitätsverbesserungen.
- Getreide: +506 neue Datenpunkte
- Gemüse: +1517 neue Datenpunkte
- Hülsenfrüchte, Nüsse, Ölsaaten und Gewürze: +1005 neue Datenpunkte
- Früchte: +1252 neue Datenpunkte
Vor einigen Monaten haben wir bereits ein grosses Daten-Release zu tierischen Produkten und Getreide veröffentlicht. Mit den neuen Datenpunkten erweitern wir die Abdeckung deutlich. Das Spannende daran: Die Modelle hinter diesen Datensätzen sind anpassbar. Wenn du Primärdaten vom Landwirtschaftsbetrieb hast, können diese berücksichtigt und unser Standardmodell entsprechend angepasst werden. Das ist besonders relevant, weil so Primärdaten vom Betrieb innerhalb derselben Methodik einfliessen können.
Wie geht es weiter?
Mit den neuen landwirtschaftlichen Zutaten auf Hofebene werden unsere verarbeiteten Zutaten automatisch aktualisiert. In den kommenden Monaten starten wir unsere Produktdatenbank. Sie baut auf diesem Release auf und umfasst übergeordnete Produkte wie Saucen, Teige, Käse und Süsswaren. Wir haben gelernt, dass die gewünschte Datengranularität bei unseren Kunden stark variiert. Die neue Produktdatenbank bringt deutlich mehr Regionalisierung auf Produktebene, indem sie Lieferketten und regionalisierte Emissionsfaktoren berücksichtigt, die auch für Handelskunden relevant sind.
Was haben wir intern verändert?
Unser Team setzt dieses Jahr deutlich stärker auf KI. Ich finde, die Coding-Tools sind inzwischen so gut geworden, dass Fachleute aus der Ökobilanzierung (LCA) ganze Architekturen entwickeln können, sobald sie mit einem Tool wie Claude Code oder Cursor vertraut gemacht wurden. An der Präzision, mit der wir Daten entwickeln, hat das nichts geändert. Wir konnten uns aber von einzelnen Skripten zu echten Datengenerierungs-Engines weiterentwickeln, die schneller sind und es uns künftig ermöglichen, kundenspezifische Datensätze schneller und präziser zu erstellen.